PrivSynth ist eine datenschutzfreundliche Alternative zu bestehenden Diensten zur Datensynthese. Statt Rohdaten an einen Drittanbieter zu übergeben, der daraus eine synthetische Version erzeugt, wird der Datensatz zuerst verschlüsselt, und ein homomorphes neuronales Netz trainiert direkt auf den verschlüsselten Daten — der Anbieter des Modells bekommt die zugrunde liegenden Werte nie zu sehen. Das ist relevant für Anwendungen, in denen Daten strengen Datenschutzvereinbarungen unterliegen, etwa Zensus-Mikrodaten oder Gesundheitsdaten.
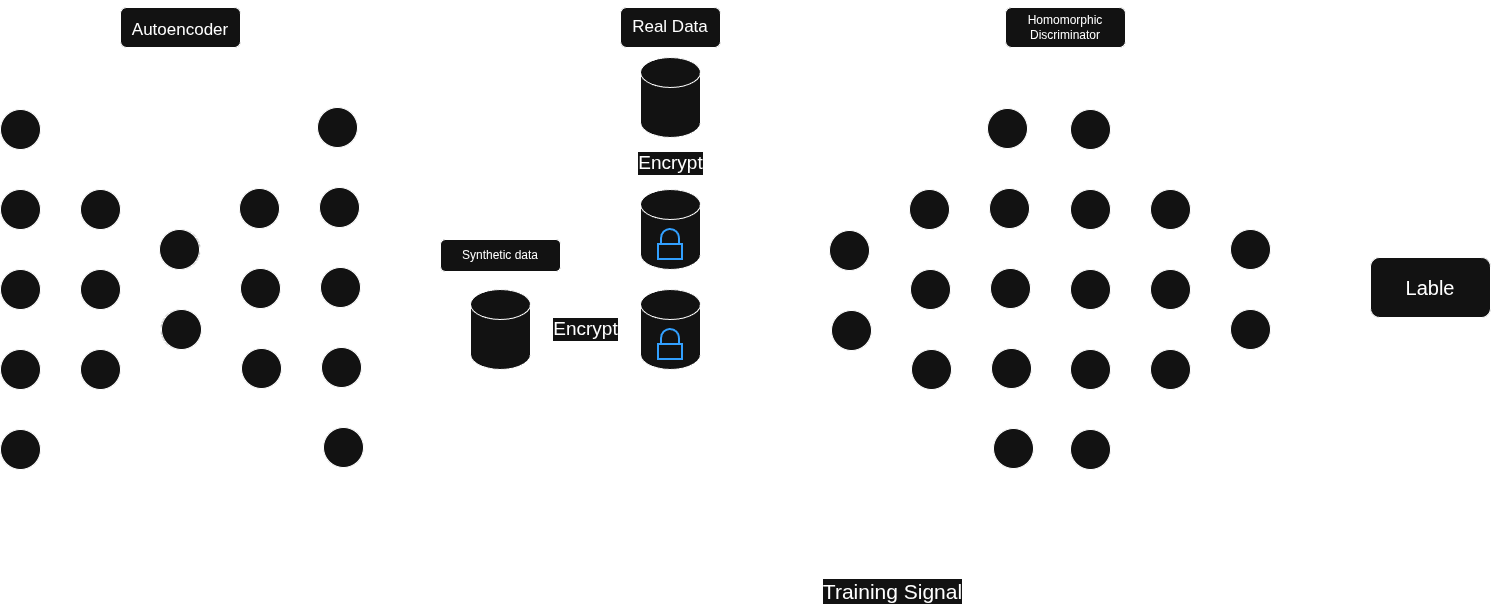
In der Ziel-Architektur lernt ein Autoencoder die Struktur der realen Daten und erzeugt synthetische Zeilen. Sowohl die realen als auch die synthetischen Daten werden anschließend mit CKKS verschlüsselt, einem homomorphen Verschlüsselungsschema, das approximative Arithmetik auf verschlüsselten reellen Zahlen unterstützt. Ein homomorpher Diskriminator bewertet die verschlüsselten realen und synthetischen Daten direkt — ohne sie jemals zu entschlüsseln — und erzeugt ein Label real vs. synthetisch. Dieser Score wird als Trainingssignal an den Autoencoder zurückgegeben und schließt so die adversariale Schleife, ohne dass dabei je ein Rohwert offengelegt wird.
Die aktuelle Implementierung deckt den adversarialen Trainingskern ab: einen WGAN-GP-Generator und -Kritiker, gebaut mit TensorFlow/Keras, mit einer Vorverarbeitung, die kontinuierliche Merkmale skaliert (MinMaxScaler) und kategoriale One-Hot-kodiert, bevor generierte Samples zurück in menschenlesbare Zeilen transformiert werden. Getestet wird gegen personenbezogene Iowa-ACS-PUMS-Mikrodaten. Die homomorphe Verschlüsselungsseite der Pipeline — das Verschlüsseln der Daten und deren Bewertung durch den homomorphen Diskriminator — befindet sich noch in der Planung und ist noch nicht Ende-zu-Ende verdrahtet.
Technologien: TensorFlow, Keras, WGAN-GP, homomorphe Verschlüsselung (CKKS), pandas, scikit-learn